TML OPD 博客的 $\gamma$ 在哪里?他们的原文写的是:
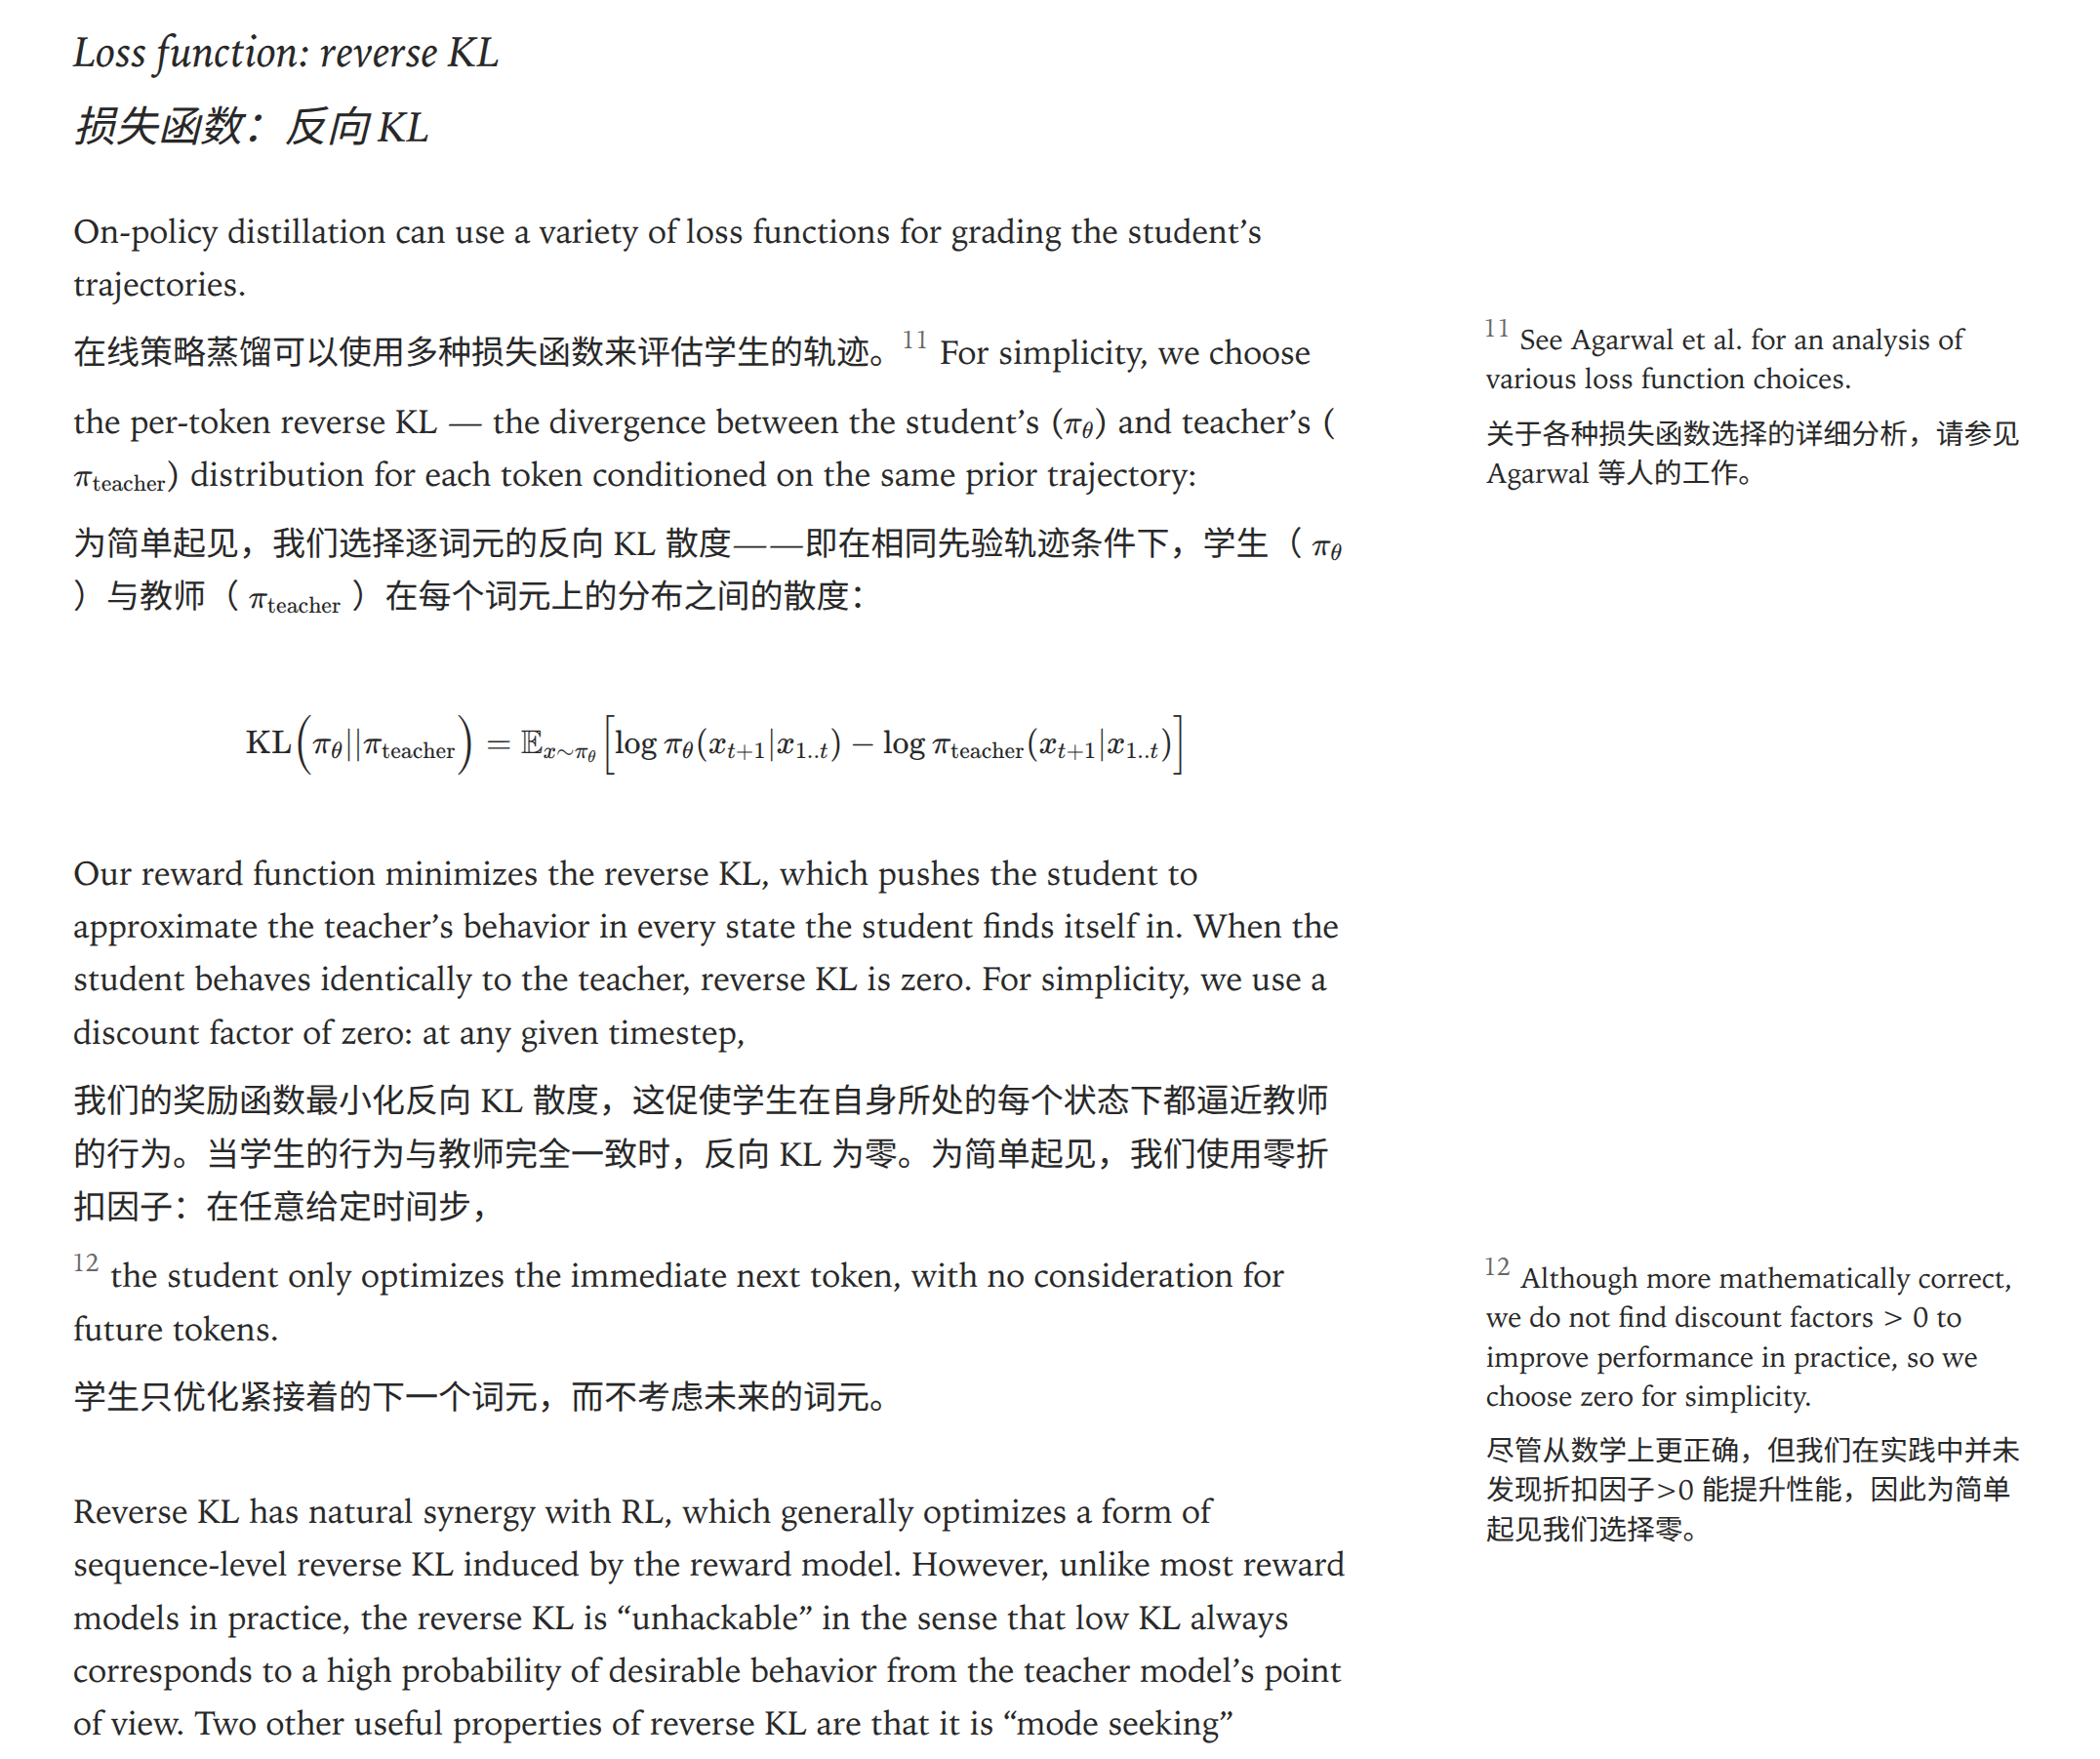
「折扣因子」是什么?它不在公式里。作为初学者我很困惑 🤔。
$\gamma$ 在哪里?
Token-level OPD
如上图所示,TML 的逐词元 loss 已经定义为了:
其中 $ c_t=(x,y_{<t})$。上式是 token-level 的 loss。我们先顺着这个熟悉的式子推一遍它的梯度。
常见 log-derivative trick:
所以有
请注意 score-function identity:
综上,有:
定义:
其中 $s_t$ 是 score function,$r_t$ 是 log-ratio。整理梯度得:
所以,定义梯度的 Monte Carlo estimator:
它是无偏的(当把 $c_t$ 视为已经采样好的固定 context 时),如果 $y_t\sim\pi_\theta(\cdot|c_t)$,那么
对于采样一个 token $y_t$ 得到的单样本无偏 Monte Carlo 梯度估计量 $\hat{g}_t$,设计 surrogate loss,使得它 .backward() 之后产生 $s_t r_t$:
等到真正训练的时候,因为 rollout 是由采样时的 policy $\pi_{\mathrm{samp}}$ 产生的,要再加一个 importance sampling ratio,
其中
因此
如果正处于完全 on-policy 点,即当前 learner 就是刚刚用于 rollout 的 policy,那么
那么
那么
以上就是 TML 的 token-level OPD。
上面一直看的是单个位置 $t$。对于一条长度为 $T$ 的 student rollout,
每个位置都有一个局部梯度估计
TML 的 token-level OPD 对整条 rollout 的梯度估计,就是把各位置的局部贡献直接相加。estimator 定义为:
每个 token 只使用自己当前位置的 log-ratio $r_t$ 作为训练信号,并不会把未来位置的 $r_{t+1},r_{t+2},\ldots$ 回传给当前 token。
为什么 $\hat g_{\mathrm{tok}} = \sum_{t=1}^T\hat g_t$?这合适吗?如果目标是精确估计完整 trajectory reverse-KL 的梯度,它是有偏的。
Sequence-level OPD
对于 prompt $x$,完整 response 为 $y=(y_1,\ldots,y_T)$。sequence-level OPD 的目标是
用刚刚一样的推导梯度,
利用常见的 log-derivative trick:
所以有
再利用 zero-mean score identity:
得到:
用刚刚一样的记号,记
语言模型是自回归的,
还有
因此,目标的梯度整理为:
因此,sequence-level 的 estimator 定义为:
当 $t’ < t$ 时,因为
所以
这里全期望公式是因为固定 $c_t$ 时,$r_{t’}$ 不随当前的 $y_t$ 变化,我补一下解释:
因此可以把 gradient 改写成 causal return-to-go:
回忆一下,token-level 的 estimator 是:
由此可见,TML 的 token-level 的 estimator 是有偏的。
γ 在哪里?
把 immediate token-level 和完整 sequence-level 写进同一个 estimator,这样它们就是这个折扣 return-to-go estimator 的特例:
$\gamma$ 就是在这里。😉
References
TML 让 $\gamma = 0$。这是有偏的。但是方差会更小。证明在Yuqian Fu 等人写的文章和他们的论文里。
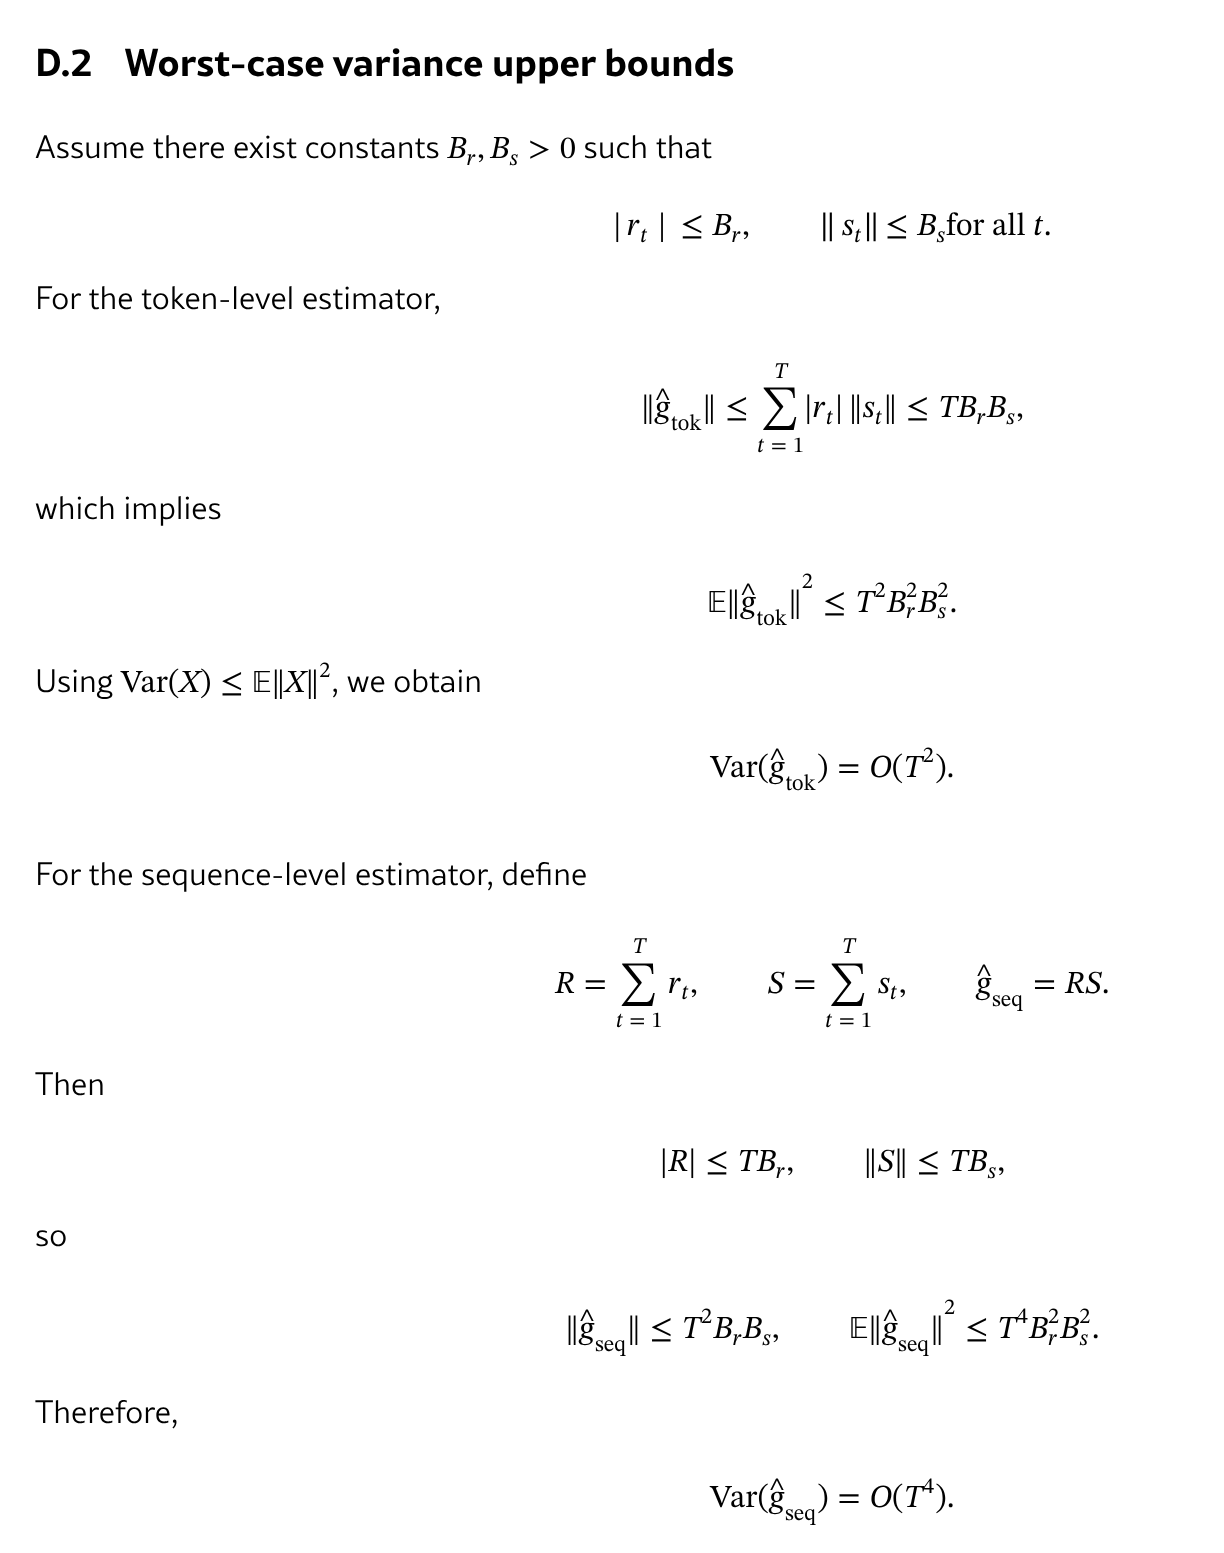
他们还发现了 sampled-token OPD 的其他问题。而且,他们还研究了介于单 token 和全词表之间的「teacher top-K 局部匹配」。
我主要阅读了他们分享的知乎内容。
另外 TML 的思路首先是:
然后训练,只有当
时,它才额外调用:
所以另一个视角就是,所谓 $\gamma=0$,从 RL 语言里几乎立即得到:
没有必要先证明
欸,那我这篇博客不就是白写了。